「もう一度お願いします」をやめて「もしかして◯◯でしょうか」にした
44%。9月に、本番の45日ぶんの通話を集計して出た、ホテル名の検索が0件で終わった割合だ。地名のほうも27%が決まらずに終わっていた。 AIは聞き取れた言葉で律儀に探して、無いと「もう一度お願いします」と言う。だがお客様は同じ名前をもう一度言うだけで、結果は変わらない。
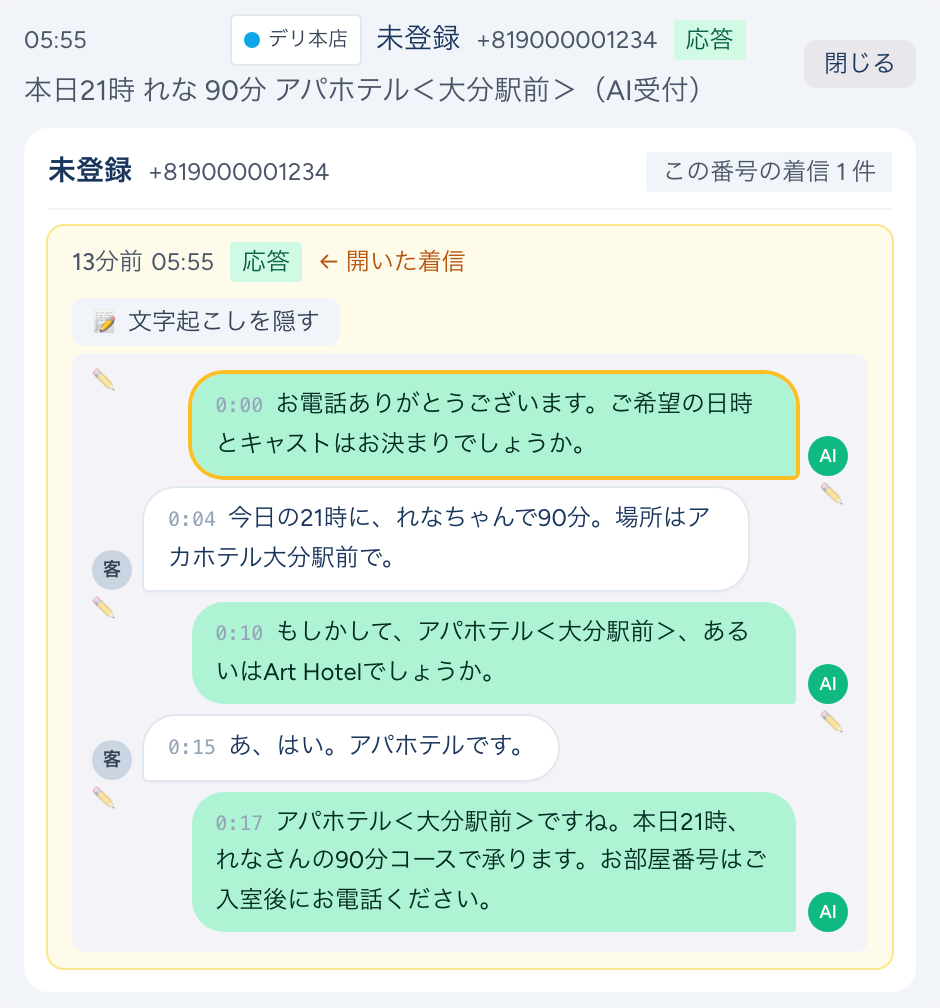
1文字違いは、聞き直すより当てにいく
失敗の型を通話ごとに見ていくと、ほとんどが1文字の聞き間違いだった。アパがアカ、アミスタッドがナミスタッド。 9月12日の外国語の通話では、お客様が自分から綴りを言い出すまで3回から5回空振りしている。 9月15日の韓国語の通話はもっと痛くて、「オイタ」と書き起こされた大分が、登録してある読みの「オオイタ」に部分一致せず、5回空振りして3分半かかった。
だから、0件のときの返事を「もしかして◯◯でしょうか」に変えた。 このデリヘル管理アプリのホテルの登録には読みが付いているので、聞き取った言葉と登録の読みの両方を、ひらがなはカタカナに、長音と促音と小さい母音は落とし、「オオ」のような同じ母音の連続は1つに畳んでから、何文字直せば一致するかで比べる。 その距離が小さい順に3件まで候補にして、AIには上の2件を読み上げさせる。
どこまで近ければ候補にするかは、言葉の長さで変えた。4文字未満は推測しない。4、5文字なら1文字違いまで、6文字から9文字なら2文字まで、10文字以上なら3文字まで。 短い名前で2文字も許すと、別のホテルが平気で候補に上がる。「ホテル」だけの検索語も、漢字だけで読みが取れない語も、推測の対象から外している。 支店名まで言わないお客様のために、登録の読みのほうが長いときは先頭の同じ長さだけを比べる。
推測で予約を作らない
候補はこちらの推測であって、お客様の言葉ではない。だから候補のまま予約には使えない作りにした。 AIは候補の名前を読み上げて、お客様が「はい」と言ったら、その名前でもう一度検索して、そこで出てきたホテルの番号で予約を作る。 候補の番号を直接渡すと、予約の手前で止まる。否定されたら次の候補、全部否定されてはじめて、1文字ずつ綴ってもらうお願いに進む。 店が「案内しない」と決めたホテルは、候補にもならない。
作ってすぐ、並び順を直した。「アカホテル大分駅前」の「大分駅前」は読みの照合には乗らないが、支店を指す手がかりとしては大きい。 最初の版では読みの距離だけで並べていて、本命が3番目に落ちて読み上げから漏れることがあった。 いまは検索語の漢字を名前か住所に含む候補を先頭に置き、距離が同じなら当店で予約の多いホテルを先にしている。お客様が言いそうな所から確かめるほうが、1回で済む確率が高い。
明日は、AIに持たせる辞書を8,000字で切った話を書く。多く渡すほど良いと思っていたのが、そうではなかった。