AIに渡す辞書を8,000字で止めた
昨日の続きになる。AIの受付には、通話のたびに店の固有名詞をまとめた辞書を1枚渡している。文字起こしが「アカホテル」と聞き違えても、辞書を見て正しい名前に戻せるようにするためで、7月から入れている。 ずっと3,000字で切っていた。足りないとは思っていなかった。
9月17日に、本番の店でその辞書の中身をそのまま出して読んでみた。町名がアルファベット順に150件ほど並んだところで、もう上限に届いていた。 キャストの名前も、ホテルの名前も、1つも入っていなかった。お客様がいちばん口にする2つが、辞書の外にあったことになる。
この通話で出そうな順に詰める
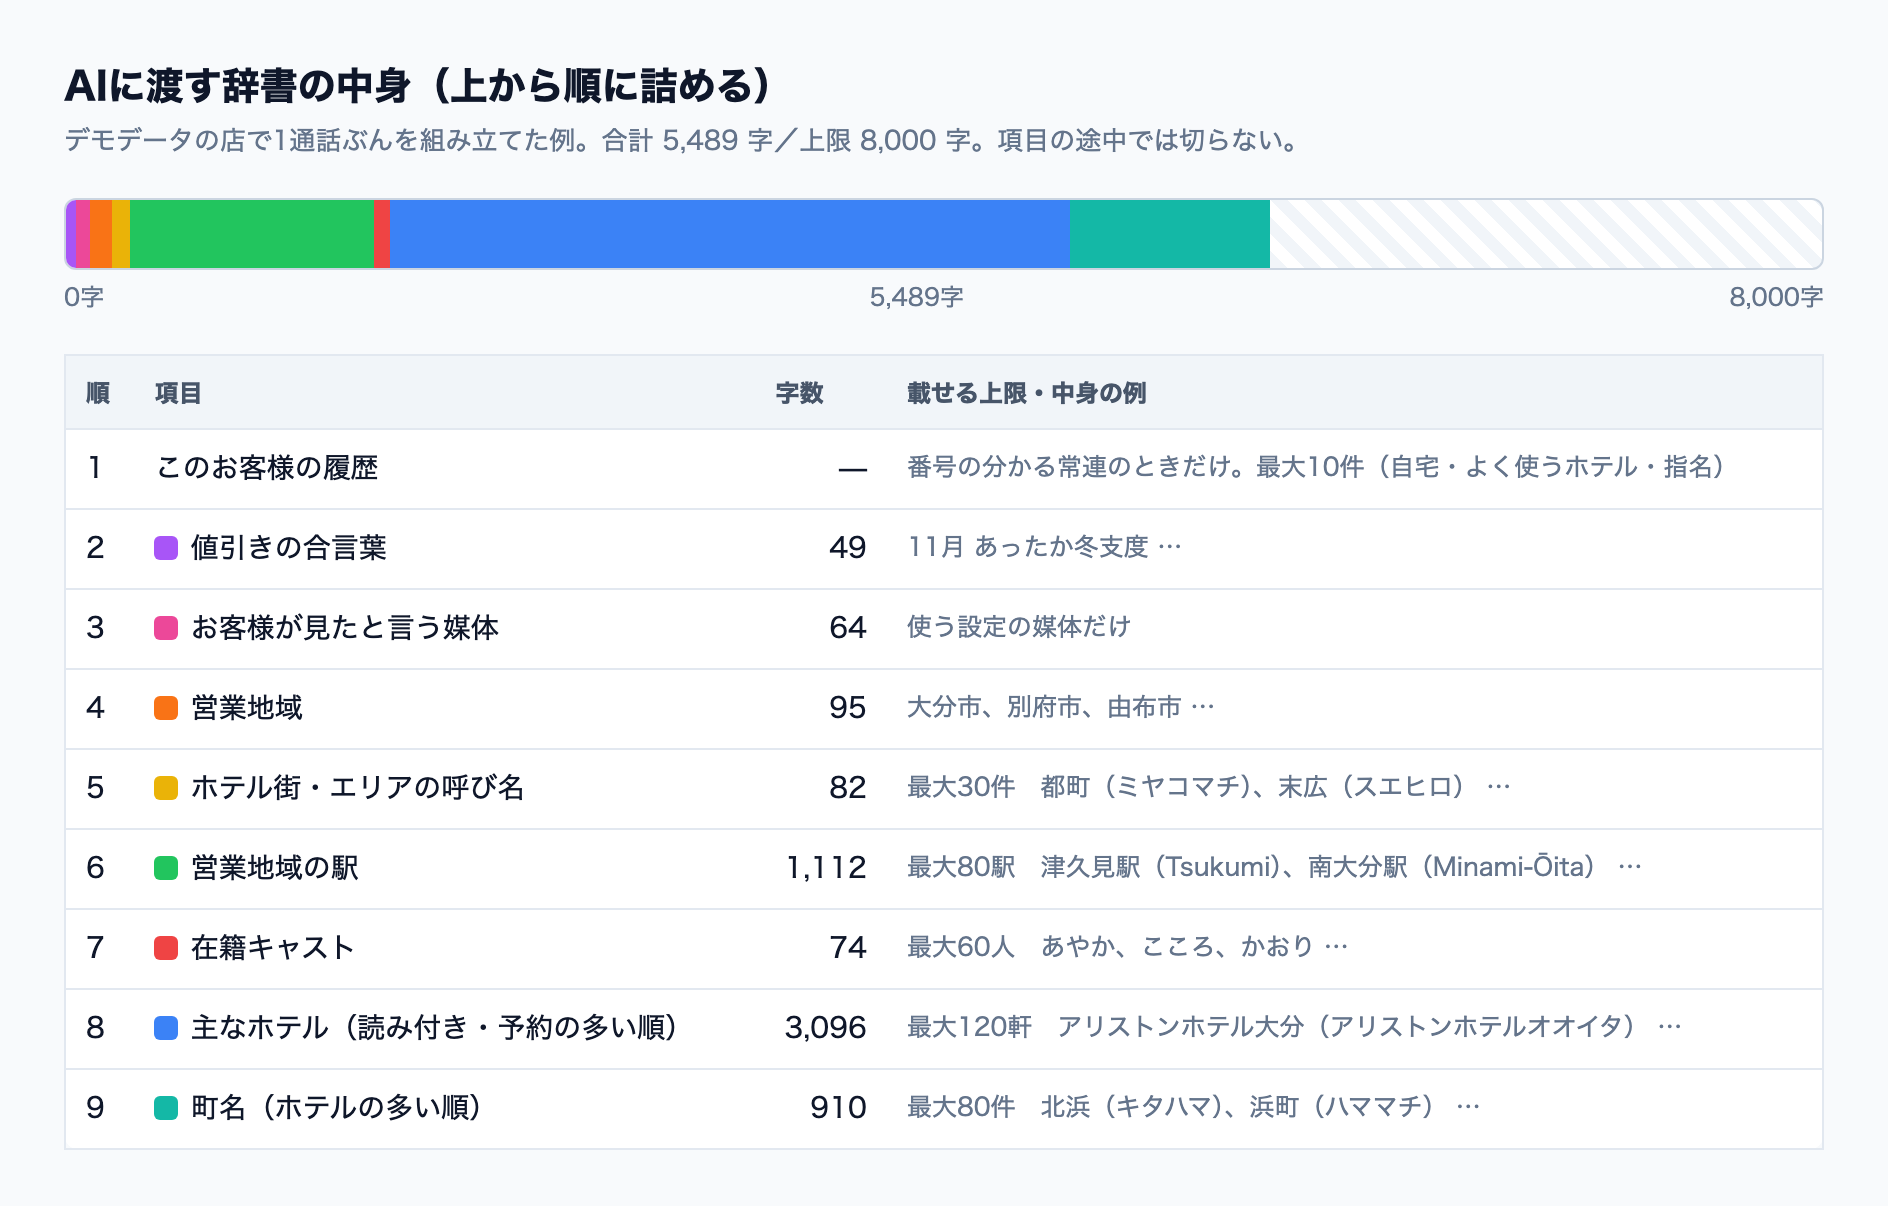
直したのは上限より先に、並び順だった。いまは、番号の分かる常連ならその人の履歴(自宅、よく使うホテル、指名)を先頭に置き、合言葉、営業地域、地元の呼び名、駅、在籍キャスト、予約の多い順のホテル、ホテルの多い町名と続ける。 この通話で出てきそうな言葉ほど上に来る。町名もアルファベット順をやめて、そこにあるホテルの数で並べた。使われない町で辞書の前半が埋まるのが、そもそもの失敗だったからだ。
詰め方も変えた。上限に届いたら、その項目の並びはそこで終える。名前の途中で切れて「アリストンホテル大」で終わる、ということはもう起きない。 外国語の通話では、駅にその言語の呼び方を添える。駅の行だけが長いのはそのためだ。
多く渡せば良いわけではなかった
足りなかったのだから、思い切り増やせばいいと最初は考えた。ところが辞書を長くするほど、AIは受付の決まりごとを守らなくなった。辞書は読ませるための資料で、指示ではない。資料が厚くなると、肝心の指示のほうが埋もれる。 それで8,000字で止めた。読み付きのホテルと駅と町名がひととおり収まり、それ以上は増やさない長さだ。
そのかわり、載せるものを絞った。読み付きのホテルは予約の多い順に120軒まで、キャストは60人、ホテル街の呼び名は30件まで。名前だけのホテルの長い一覧は、載せるのをやめた。 辞書に無いホテルは、昨日書いた読みの近い候補を探す検索のほうで拾う。 辞書は全部を覚えさせる場所ではなく、聞き違えやすい言葉を先回りして置いておく場所だと考えるようにした。デリヘル管理ツールの中では目に見えない部品だが、店の電話の取りこぼしにいちばん近い所にある。
図の店はまだ2,500字ほど余っている。ホテルの多い街の店では、120軒目で切れたその先に、どんなホテルが並んでいるのかを、そのうち見ておきたい。